上海,2026年9月21日——在华为全连接2026大会上,华为董事总经理兼ICT事业群CEO杨朝斌发表了关于计算架构创新的主题演讲,公布了UnifiedBus互连架构的最新细节,发布了一系列基于该架构的计算产品,并阐述了公司如何与开源社区合作,赋能客户、合作伙伴和开发者进行应用创新。
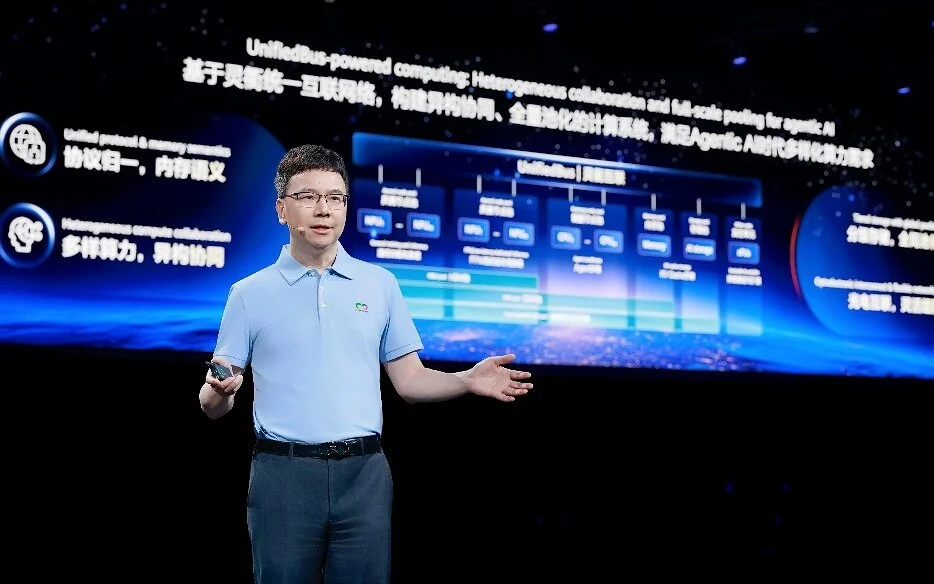
在传统的计算架构中,随着集群规模的扩大,资源利用率会下降。一个拥有10万个NPU的集群,其计算能力中只有不到20%被模型实际利用,大量计算资源在数据通信期间处于闲置状态。一个拥有10万亿个参数的模型需要海量的中间数据进行训练,这远远超过了传统架构下单个加速器的内存容量。集群内部组件之间的互连和通信已成为计算系统性能的关键瓶颈。
杨表示,华为针对这一瓶颈提出的解决方案是其全新的计算架构,该架构基于名为UnifiedBus的互连技术,能够促进集群和SuperPoD之间的协作。该架构旨在支持随着新型智能应用涌入市场而出现的计算需求激增。基于UnifiedBus的计算系统具有以下四个关键特性:
统一的协议和内存语义:UnifiedBus 协议整合了十多种互连协议,将互连带宽从 100 GB/s 级别提升至 TB/s 级别,并将往返时间 (RTT) 延迟从 7 微秒降低至 2 微秒。该协议还支持 SuperPoD 内部的统一全局内存寻址。
异构计算协作:UnifiedBus 直接互连 CPU、NPU、内存和固态硬盘 (SSD),从而实现它们之间去中心化的点对点访问以及灵活的 CPU-NPU 混合使用。此外,Transformer 的分层硬件加速支持注意力机制前馈网络 (AFD) 的解耦。
分层存储与全局池化:UnifiedBus 使用混合媒体资源池化来支持激活缓存。双倍数据速率 (DDR) 内存作为 NPU 的备用内存,降低了搜索、推荐和广告服务的延迟,并将向量检索性能提升了一倍,适用于数千维、千亿级数据项。此外,这还降低了训练 10 万亿参数模型所需的每个 NPU HBM 容量,并提高了集群模型的 FLOPs 利用率 (MFU)。
光电互连和灵活联网:UnifiedBus 可作为全球超高带宽、超低延迟的“数据高速公路”,实现计算的灵活扩展。
随后,杨谨介绍了华为最新的UnifiedBus互连产品,该产品涵盖机柜内、机柜间以及集群间的互连。这使得系统能够从单个机柜弹性扩展到拥有百万NPU的集群。
在机柜内,UnifiedBus LinkBlade 采用无电缆设计,消除了电路损耗,从而在 4.096 个 NPU 的 SuperPoD 中减少了约 196 公里的铜缆。
在机柜之间,UnifiedBus LinkDevice 支持 176 个端口,每个端口带宽为 1.6 Tbit/s,可提供 280 Tbit/s 的全光互连。这是业界带宽最高、端口数量最多的高速总线协议互连设备,RTT 延迟低至 2 微秒。
跨集群,UnifiedBus UBG 交换机提供高达 1.024 的大规模基数扇出容量,这意味着它可以支持百万 NPU 超级集群,并向支持数万亿个模型参数的方向发展。
杨谨还发布了华为基于UnifiedBus的智能体AI超级集群,该集群由泰山950和Atlas 960超级POD、OceanStor M900内存存储以及星河UBG交换机组成。该集群支持多样化的计算协作和分层资源池化。
除了SuperPoD之外,华为还将UnifiedBus技术应用于其计算设备。该公司开发了一系列基于UnifiedBus的新型设备(支持1到8个NPU)以及鲲鹏和Ascend模块,使中小企业能够在本地运行万亿参数模型。
在生态系统方面,杨表示,Ascend 正在与 DeepSeek Harness、OpenCode 和 openJiuwen 等开源框架合作,开发完全开源的智能管理、推理加速和安全框架代理插件。
杨承诺:“华为致力于系统级创新,构建计算基础产品组合,并走开源开放系统路线。我们将继续与客户、合作伙伴和开发者携手合作,助力这一生态系统蓬勃发展,为世界提供全新的计算选择。”
(逆传播海外发稿团队专注海外媒体发稿服务,10万海外媒体资源,72个语种220个国家地区,向世界传播您的品牌!)